
FollowUp 2 - die Verbesserung der Agenten
Dieser Artikel ist die zweite Fortsetzung von Wenn KI bei 29 Diagnosen hilft und Follow up - Wenn KI bei 29 Diagnosen hilft ....
Vorab ein ehrlicher Hinweis: Was ich hier beschreibe, ist eingerichtet und durchdacht, aber noch nicht mit einer Klasse erprobt. Der erste echte Lauf kommt im Januar. Ich werde berichten ...
Rückblick
Im ersten Artikel habe ich mein Agenten-Setting vorgestellt: Vier Agenten arbeiten Hand in Hand, um bei Klassen mit 27 bis 29 Schülerinnen und Schülern den Wissens- und Festigungsstand herauszufinden. Der Schleier anonymisiert, der Kartograph gleicht mit dem Bildungsplan ab, der Kompass leitet die Diagnose ab und der Trainer bereitet alles schülergerecht in gamma auf. Im Follow-up ging es dann um das Danach, also um die kleinen Mittelchen zum Zweck wie POE-Versuche und 5-Minuten-Aufgaben.
Seitdem habe ich mit dem System weitergearbeitet. Und dabei ist mir aufgefallen, an welcher Stelle es noch blind war.
Was bisher gefehlt hat
Meine Agenten haben bisher immer nur die Antworten der Schülerinnen und Schüler unter die Lupe genommen. Den Diagnosebogen selbst hat nie jemand geprüft. Ob eine Aufgabe unklar formuliert, zu leicht oder für die Diagnose eigentlich wertlos war, habe ich erst bei der Auswertung gemerkt. Und dann war es zu spät, denn die Diagnose war ja schon gelaufen.
Eine Korrekturschleife gab es zwar schon. Bei der Sichtprüfung melde ich dem System "Schlampereien" beim Schwärzen zurück, und Claude passt daraufhin das Python-Skript an. Diese Schleife macht aber nur die Anonymisierung besser. Was fehlte, war eine Schleife, die das Diagnoseinstrument besser macht, und zwar bevor die Klasse es in die Hand bekommt.
Daher überlegten ich und Claude uns einen fünften Agenten, der ganz am Anfang steht: Agent 0, den Tester.
Der Tester – ein blinder Probelauf
Der Tester füllt den Diagnosebogen so aus, wie es Schülerinnen und Schüler der Klassenstufe tun würden. Wichtig war uns dabei vor allem, was er nicht weiß: Er kennt keinen Lösungshorizont, keinen Bildungsplan und keine früheren Ergebnisse. Nur so bleibt der Probelauf wirklich blind.
Damit das Ganze aussagekräftig wird, laufen gleich drei Tester mit unterschiedlichem Vorwissen:
- Profil stark: Der Stoff der vergangenen Jahre sitzt, die Aufgaben werden genau gelesen und sauber bearbeitet.
- Profil mittel: Die Grundbegriffe sind da, beim Transfer und bei der Fachsprache wird es aber wackelig. Teilaufgaben werden auch mal übersprungen.
- Profil schwach: Argumentiert wird mit Alltagsvorstellungen, die typischen Fehlvorstellungen der Stufe sind vorhanden, gelesen wird ungenau, und bei langen Texten wird aufgegeben.
Jedes Profil bekommt einen eigenen, frischen Subagenten (also eine eigenständige KI-Instanz). Die drei arbeiten gleichzeitig und wissen nichts voneinander. Einen Abzweig aus dem laufenden Chat haben wir bewusst verboten, denn der würde den ganzen Verlauf mitnehmen und damit eventuell auch die Lösungen.
Jeder Tester gibt mir zu jeder Aufgabe seine Antwort zurück, außerdem wie sicher er sich ist (1 bis 4), wie lange er gebraucht hätte, welche Verständnisfragen er hat und wo er gestolpert ist (z. B. über ein Wort, eine Abbildung oder zu wenig Platz zum Schreiben). Erst wenn alle drei fertig sind, öffnet Claude den Lösungshorizont und vergleicht.
Den Tester gibt es in zwei Varianten:
- Modus A: Er prüft den Diagnosebogen, bevor ich ihn in der Klasse einsetze.
- Modus B: Er prüft Übungs- und Abruftests, bevor sie in Moodle oder ILIAS landen. Hier schaut er zusätzlich, ob man die Antworten auf der Lernplattform überhaupt eintippen kann.
Zwei Feedback-Schleifen
Vor dem Einsatz: die Ampel
Nach dem Vergleich bekommt jede Aufgabe eine Ampelfarbe: grün heißt einsetzbar, gelb heißt kleine Änderung, rot heißt überarbeiten oder streichen. Dabei schaut das System unter anderem auf diese Punkte:
- Trennschärfe: Gut ist eine Aufgabe, wenn das starke Profil sie löst und das schwache nicht. Lösen sie alle, ist sie zu leicht.
- Diagnosewert: Kommt das schwache Profil trotz seiner Fehlvorstellung zur richtigen Lösung (z. B. durch Raten oder Abschreiben aus dem Material), dann ist die Aufgabe für die Diagnose blind.
- Mehrdeutigkeit: Findet ein Tester eine fachlich vertretbare Antwort, die nicht im Lösungshorizont steht, wird der Horizont erweitert oder die Aufgabe klarer formuliert.
- Sprache und Zeit: Stolpern die Tester über Wörter, die mit dem Fachinhalt gar nichts zu tun haben? Braucht das mittlere Profil länger als geplant?
- Motivation: Gibt es einen leichten Einstieg und mindestens eine Aufgabe mit einem Phänomen oder Alltagsbezug?
Alles wird in einem Prüfprotokoll festgehalten. Bei jeder gelben oder roten Aufgabe entscheide ich mit einem Kürzel: Ü für übernehmen, M für abgewandelt übernehmen und A für ablehnen (z. B. weil eine Aufgabe bewusst schwer sein soll). Danach laufen nur die geänderten Aufgaben noch einmal durch drei neue Tester. Nach höchstens zwei Runden ist Schluss, denn dann ist die echte Klasse sowieso der bessere Test.
Nach dem Einsatz: die Kalibrierung
Die zweite Schleife startet nach der Diagnose. Zu jeder Aufgabe wird eine kleine Itemanalyse erstellt: Wie viele haben sie gelöst, wie viele teilweise, welche Fehlvorstellungen tauchten auf? Ab zehn Einzelbögen kommt noch eine einfache Trennschärfe dazu. Danach vergleicht das System die Vorhersage des Testers mit dem, was in der Klasse wirklich passiert ist: Welche Aufgaben waren tatsächlich leicht, welche haben getrennt und welche waren zu schwer?
Die echten Ergebnisse gehen dabei nie an die Tester, die gerade laufen, sonst wären sie ja nicht mehr blind. Sie wandern stattdessen in eine Profilbibliothek für die nächsten Läufe. Dort stehen Fehlvorstellungen, typische Schreibmuster und realistische Bearbeitungszeiten einer Klassenstufe. Das alles nur auf Gruppenebene, umformuliert, ohne Codes und ohne wörtliche Schülerantworten. Ein Profil gilt erst dann als "kalibriert", wenn mindestens drei Diagnosen derselben Stufe mit diesem Abgleich vorliegen. Bis dahin heißt es ehrlicherweise "vorläufig".
Nulltoleranz bei Formeln
Als Chemielehrer war mir eine Sache besonders wichtig: Eine chemische Formel zählt nur dann als richtig, wenn sie vollständig und korrekt geschrieben ist. Das gilt jetzt für alle Agenten:
- Indizes stehen tiefgestellt: H₂O, CO₂, Ca(OH)₂.
- Ionenladungen stehen hochgestellt rechts oben, die Zahl vor dem Vorzeichen: Fe³⁺, SO₄²⁻. Bei einfacher Ladung steht nur das Vorzeichen: Na⁺, OH⁻.
- In Ionen- und Redoxgleichungen muss die Ladungsbilanz stimmen.
"H2O" oder "Fe+3" sind damit nicht mehr "teilweise richtig", sondern falsch. Bei Handschrift gilt: Steht ein Index eindeutig auf der Grundlinie, ist die Formel falsch. Lässt sich auf dem Scan nicht entscheiden, was gemeint ist, wird "unleserlich" vermerkt. Es wird also weder zugunsten der Schülerin oder des Schülers gedeutet noch geraten.
Mit dieser Regel habe ich meine bisherigen Diagnosen nachkodiert. Und das Ergebnis hat mich überrascht: Das Tiefstellen klappt meistens. Die Fehler stecken ganz woanders, nämlich in Elementsymbolen mit falscher Groß- und Kleinschreibung ("CL" statt Cl), in Salzformeln ohne Index und darin, dass statt einer Formel nur der Name des Ions hingeschrieben wird. Genau solche Muster landen jetzt in der Profilbibliothek.
Ein praktisches Problem bleibt allerdings: In Moodle oder ILIAS lassen sich tiefgestellte Zahlen kaum eintippen. Die Lösung ist aber nicht, den Maßstab zu senken, sondern das Eingabeformat zu ändern (z. B. Auswahl, Zuordnung, Drag-and-drop, Lücken mit vorgegebenen Indexfeldern oder eine Zeichenpalette mit Anleitung). Genau das prüft der Tester in Modus B.
Der Kompass und seine fünf Fragen
Im ersten Artikel habe ich über den Kompass nur geschrieben, dass er Lernwege, didaktische Strategien und den Förderbedarf der Klasse ableitet. Inzwischen arbeitet er nach festen Regeln. Er beantwortet immer fünf Fragen, und zwar genau in dieser Reihenfolge:
- Wo sind die Lücken? Getrennt nach Theorie und Praxis und sortiert danach, wie wichtig sie für die nächste Einheit sind, wie viele in der Klasse betroffen sind und wie hartnäckig die Fehlvorstellung ist.
- Was kann die Klasse schon? Gemeint ist das, was mindestens etwa drei Viertel sicher können. Diese Stärken nutzen wir als Hebel.
- Wie lernt die Klasse? Hier geht es nicht um "Lerntypen", sondern um Merkmale, die das Lernen nachweislich beeinflussen: Vorwissen, Fehlvorstellungen, Interesse und Selbstkonzept, Arbeitsweise und Fachsprache.
- Welche Gruppen gibt es noch? Zwei bis vier, jeweils mit ungefährer Größe, aber nie als Etikett für einzelne Schülerinnen und Schüler.
- Wie geht es weiter? Höchstens drei Schwerpunkte für die nächsten vier bis sechs Wochen. Möglichst so, dass sie in den laufenden Unterricht passen, denn für eigene Wiederholungsblöcke fehlt bei der Stofffülle meistens die Zeit.
Zu jedem Schwerpunkt gibt es eine Motivationsprüfung, die nicht übersprungen werden darf. Gibt es Wahlmöglichkeiten (Autonomie)? Sind frühe, erreichbare Erfolge eingeplant (Kompetenzerleben)? Gibt es Phasen, in denen zusammengearbeitet wird (Eingebundenheit)? Und gibt es ein Experiment, ein Phänomen oder einen Alltagsbezug (Faszination)? Reine "Reparaturstunden" ohne mindestens eines dieser Elemente sind nicht erlaubt. Über allem steht die Leitplanke: Die Schülerinnen und Schüler sollen den Spaß am Fach nicht verlieren.
Ein Wort zu "Lerntypen": Modelle wie VAK oder VARK sind sehr beliebt. Dass Unterricht im "passenden" Lerntyp besser wirkt, ist empirisch aber nicht belegt (Pashler et al., 2008; Kirschner, 2017). Was dagegen wirkt: Inhalte so darzustellen, wie es zum Inhalt passt, gerne in mehreren Darstellungsformen, und am Vorwissen anzusetzen. Diesen Hinweis schreibt der Kompass in jeden Bericht.
Das System als Ganzes
Mit dem Tester sind es jetzt fünf Agenten. Zwischen ihnen gibt es zwei Tore, die nur ich öffnen kann, und an vier Stellen sorgen Sperren dafür, dass ein Agent bestimmte Informationen gar nicht erst zu sehen bekommt.
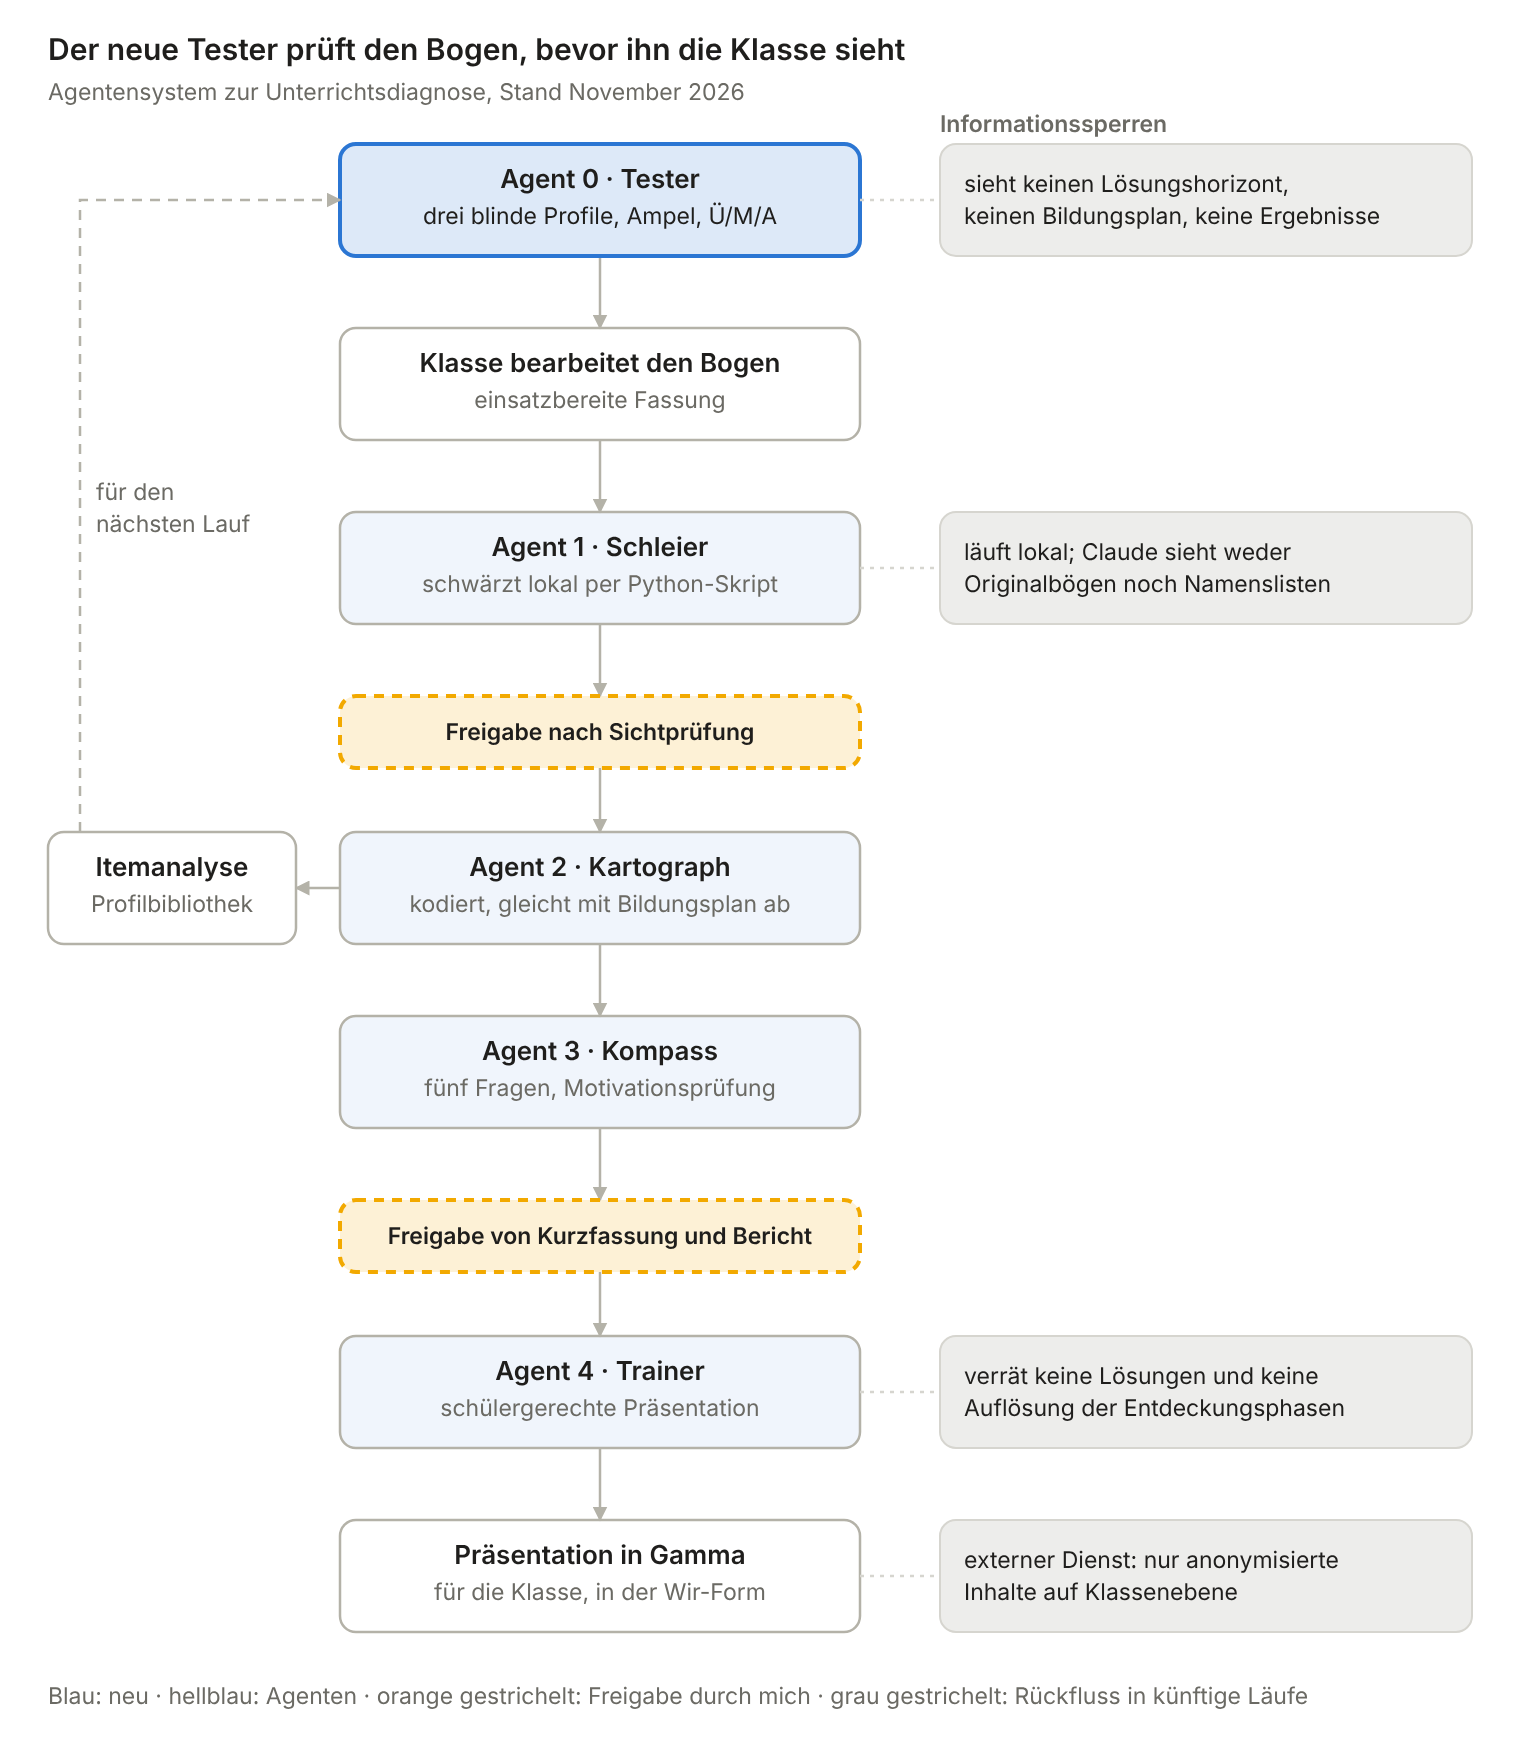
Gelesen wird die Grafik von oben nach unten: Erst wenn ich die Schwärzung geprüft und freigegeben habe, kommen die Daten beim Kartographen an. Und erst wenn ich den Bericht freigegeben habe, baut der Trainer die Präsentation. Die gestrichelte Linie links ist die neue Schleife nach dem Einsatz: Die echten Ergebnisse verbessern die Profile des Testers, aber eben erst für den nächsten Lauf.
Lessons learned beim Datenschutz
Im ersten Artikel habe ich geschrieben, dass die Diagnose DSGVO-konform läuft und Claude nur auf das Folder mit den geschwärzten Bögen Zugriff hat. Heute würde ich das vorsichtiger formulieren: Das System ist datenschutzbewusst gebaut und mehrfach abgesichert, aber fehlerfrei ist es nicht. Inzwischen liest Claude auch die anonymisierten Auswertungen, die Bildungspläne und die leeren Vorlagen. Die Originalbögen und die Namenslisten bekommt die KI aber weiterhin nicht zu sehen.
Dreimal ist trotzdem etwas durchgerutscht. Beim letzten Mal hat das System sofort gestoppt, den Namen nicht wiederholt und mich informiert. Und jedes Mal ist daraus eine feste Regel geworden:
| Was passiert ist | Regel seitdem |
|---|---|
| Eine Auflistung aller Unterordner zeigte Dateinamen, und Dateinamen können Vornamen enthalten. | Im Folder mit den Originalbögen werden keine Dateien aufgelistet, nur die Ordnernamen der Lerngruppen. Rekursive Auflistungen sind verboten. |
| Im Seitenkopf standen handschriftliche Vermerke, die das Skript nicht als Namen erkannt hat. | Seitenkopf und Seitenränder werden immer geschwärzt, egal was dort steht. |
| Ein Scan lag gedreht im Querformat vor. Die Schwärzung traf deshalb die falschen Stellen, und ein Vorname im Namensfeld blieb trotz Freigabe sichtbar. | Querformat-Seiten werden vor dem Schwärzen hochkant gedreht, und vor der Freigabe wird die Ausrichtung geprüft. Die Kopien in der Cloud wurden gelöscht. |
Die wichtigste Lehre für mich: Meine Sichtprüfung bleibt unverzichtbar, und auch ich bin nicht unfehlbar. Deshalb gibt es mehrere Sicherungen hintereinander, und eine Freigabe wird sofort zurückgenommen, sobald irgendwo ein Name auftaucht. Ob so ein Setting rechtlich als "DSGVO-konform" durchgeht, sollte übrigens jede Schule mit ihrer bzw. ihrem Datenschutzbeauftragten klären.
Stolpersteine und ehrliche Grenzen
- KI kann Unwissen nur nachahmen: Unklare Formulierungen, Zeitprobleme und Lücken im Lösungshorizont findet der Tester zuverlässig. Wie schwer eine Aufgabe für echte Jugendliche ist, kann er aber nur grob abschätzen. Das Prüfprotokoll gibt also Hinweise, es ersetzt keine Erprobung in der Klasse.
- Noch kein echter Lauf: Alles, was ich über den Tester schreibe, ist eingerichtet, aber noch nicht mit einer Klasse getestet.
- Kleine Stichproben: Meine bisherigen Diagnosen beruhen oft auf Gruppenbögen und auf je einem Team pro Station. Die Profilbibliothek ist deshalb noch "vorläufig", und eine Einzeldiagnose nach ein paar Wochen bleibt wichtig.
- Handschrift: Im ersten Artikel habe ich geschrieben, dass die Handschrift einwandfrei erkannt wird. Für normalen Text stimmt das meistens. Bei kleinen Indizes und Ladungen lässt sich auf einem Scan aber nicht immer entscheiden, was gemeint ist. Dafür gibt es jetzt die Kategorie "unleserlich".
- Die Verantwortung bleibt bei mir: Jede Freigabe, jeder Bericht und jede Präsentation geht über meinen Tisch.
Ausblick
Der erste echte Probelauf des Testers kommt mit der nächsten Diagnose nach Weihnachten. Danach folgt der erste Abgleich zwischen dem, was der Tester vorhergesagt hat, und dem, was in der Klasse tatsächlich herauskam.
Außerdem sind zwei weitere Agenten in Planung, die aus der Diagnose Übungs- und Abruftests für die Lernplattform bauen sollen: der Prüfstein für Moodle und der Zwilling für ILIAS. Beide gibt es bisher nur auf dem Papier. Sobald sie laufen, schaut sich der Tester ihre Tests in Modus B an, bevor sie auf der Plattform landen.
Alles in allem wird das Agentensystem mit jedem Durchlauf ein Stück besser. Ich werde weiter berichten ...
Zum Herunterladen
Ihr könnt in diesem Artikel die überarbeitete Beschreibungs- und Einrichtungsdatei des Agentensystems herunterladen, jetzt mit Agent 0 und der Nulltoleranz-Regel (Lizenz CC BY 4.0). Die Pfade sind allgemein gehalten, die müsst ihr an eure eigene Ordnerstruktur anpassen.
Wenn euch der Tester gefällt, lasst mir gerne einen Kommentar da. Mich würde interessieren, mit welchem System ihr arbeitet und was der Tester bei euren Bögen gefunden hat.
Interessante Artikel
Wenn KI bei 29 Diagnosen hilft
Follow up - Wenn KI bei 29 Diagnosen hilft ...
Quellen
- Pashler, H., McDaniel, M., Rohrer, D. & Bjork, R. (2008). Learning Styles: Concepts and Evidence. Psychological Science in the Public Interest, 9(3), 105–119.
- Kirschner, P. A. (2017). Stop propagating the learning styles myth. Computers & Education, 106, 166–171.
Kommentare
Noch keine Kommentare.